 xhyapi
判断一个 GPT 中转站靠不靠谱,要分清两个概念:账号类型和账号渠道。
账号类型和账号渠道
| 概念 | 指什么 | 常见情况 |
|---|---|---|
| 账号类型 | 账号本身的类型 | Plus、Pro |
| 账号渠道 | 账号从哪里来 | 自购自营、上游进货 |
账号类型写着 Pro,不代表账号由中转站自己购买。账号掌握在谁手里,决定了出现问题时谁能处理。
0.0 几倍率为什么不稳定?
市面上有些号池能卖到 0.0 几倍率,这种价格只有漏洞号才能做到。
- 账号类型:通常是 Plus
- 账号成本:极低,所以倍率也能压得很低
- 稳定性:漏洞被修复或者账号被封,整个号池就会直接失效
这种池子也不是不能用,自己评估——但它一定会经常不稳定。便宜在哪,风险就在哪。
Pro 号池也要看渠道
| 账号渠道 | 稳定性 |
|---|---|
| 中转站自购自营 | 账号掌握在自己手里。OpenAI 正常的情况下,不会因为上游断供而突然挂掉。 |
| 从上游进货 | 上游账号失效,中转站也会跟着失效;上游没有补货,中转站只能等。 |
怎么判断有没有掺水掺假?
在排除 OpenAI 故障的情况下,可以观察这三个信号:
- 长期稳定,很少出现整池失效,说明账号渠道大概率掌握在运营者手里。
- 经常挂、频繁换池,说明账号来源不稳定。
- 每次出问题都要等上游处理,说明它依赖第三方账号供应。
还有一个观察点:只要出了问题,修复得都比较慢,说明后面大概率有上游——自己的号自己能处理,等别人的号只能干等。
一家中转站明面上说自己使用 Pro 号池,却反复出现这些情况,那它宣传的“Pro 号池”就值得怀疑。
两个问得最多的问题
一、OpenAI 崩了,中转站为什么没崩?
很简单:OpenAI 崩,不一定是全崩,很多时候是部分崩。这个我自己就经历过——最近一次官方故障,我这边确实有一部分号被限流,但另一部分号完全没事。中转站用的号刚好落在没崩的那部分里,它就还能用。
所以别一看官方崩了、站还活着,就断定它掺了别的模型。不是黑科技,是运气好。
二、会不会偷偷掺豆包?
就是模型挂了,拿便宜模型顶上。分情况算笔账:
- Plus 号池(漏洞号):还真不一定掺。漏洞 Plus 号的成本接近 0,豆包再便宜也要成本——掺豆包反而更贵,图什么呢?而且豆包的智商跟不上,掺了一用就能看出来。
- Pro 号池:有掺的动机。Pro 号池的成本是实打实的。但掺完豆包智商立刻露馅,一旦被发现,打的是自己的口碑。
- 真正会掺的,是那种两三天就跑路的水站:把成本压到足够低,甚至拿 Plus 号去填 Pro 号。
使用记录里的三个硬指标
嘴会说谎,使用记录不会。怎么判定一个中转站有没有上游、是不是真 Pro 池?答案就在你自己的使用记录里,三个指标一查一个准。
指标一:缓存命中率
真 Pro 号,缓存命中率能到 94% 以上——请求一直打在同一批号上,缓存是热的。
要是它宣称 Pro 号池,缓存命中率却很低,说明后面是一堆号在路由。一堆什么号?Plus 号。Plus 号额度低,A 号用完就得切 B 号;只要一切换账号,模型缓存就得重新构建,命中率就降下来了。
指标二:首字延迟
没上游的站,首字两三秒就出来了;十秒之内都算正常,频繁超过十秒这个指标就发黄了。要是经常几十秒才出第一个字——先排除你自己网络的问题——排除之后还这么慢,那就是 100% 有上游:只有链路足够长,首字才会拖到几十秒。而且首字拖得越长,链路就越长,可能是你接了上游,上游又接了上游。
我潜伏在别的中转站群里见过:有人喊怎么这么慢,一看首字,五十多秒。我们自己站从来没见过五十多秒的首字。
指标三:报错频率
频繁报错的站,大概率也有上游:上游接了很多下游,负载一高就报错;链路一长,首字变长,还会超时报错。没上游的站,正常情况下不该有什么错误。
真实使用记录长什么样
这是我们站后台的真实使用记录(已避开用户邮箱等隐私列):缓存那一列,几万到二十几万 token 条条在命中;首字那一列,基本两三秒到四五秒,偶尔十几秒,找不到几十秒的。
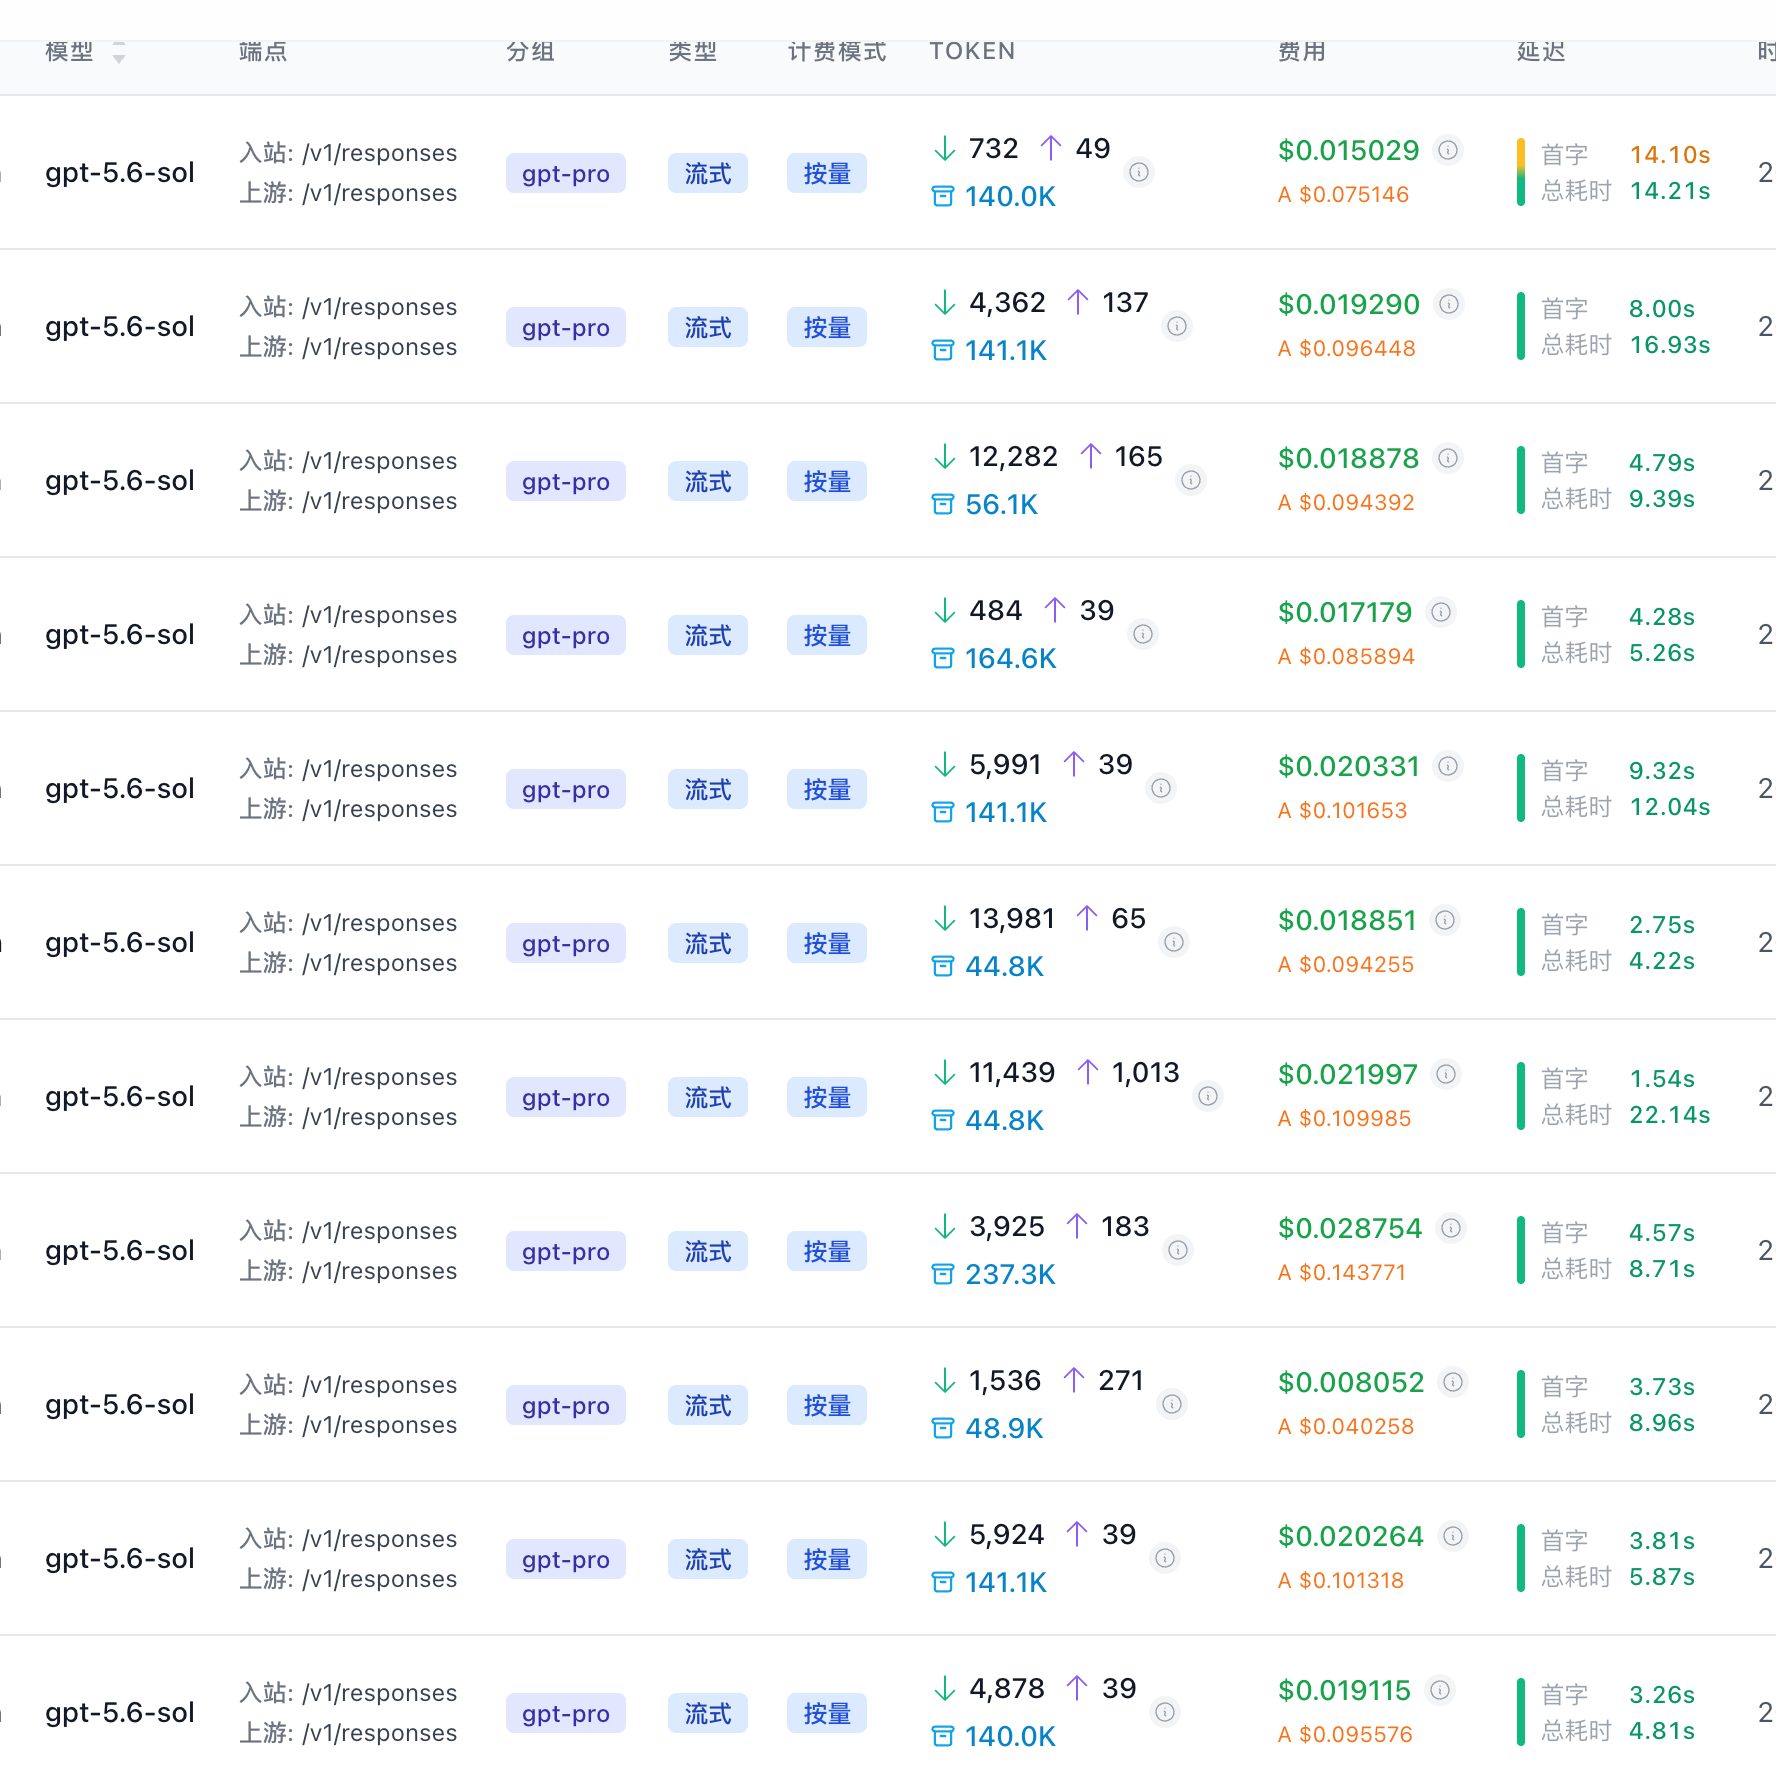
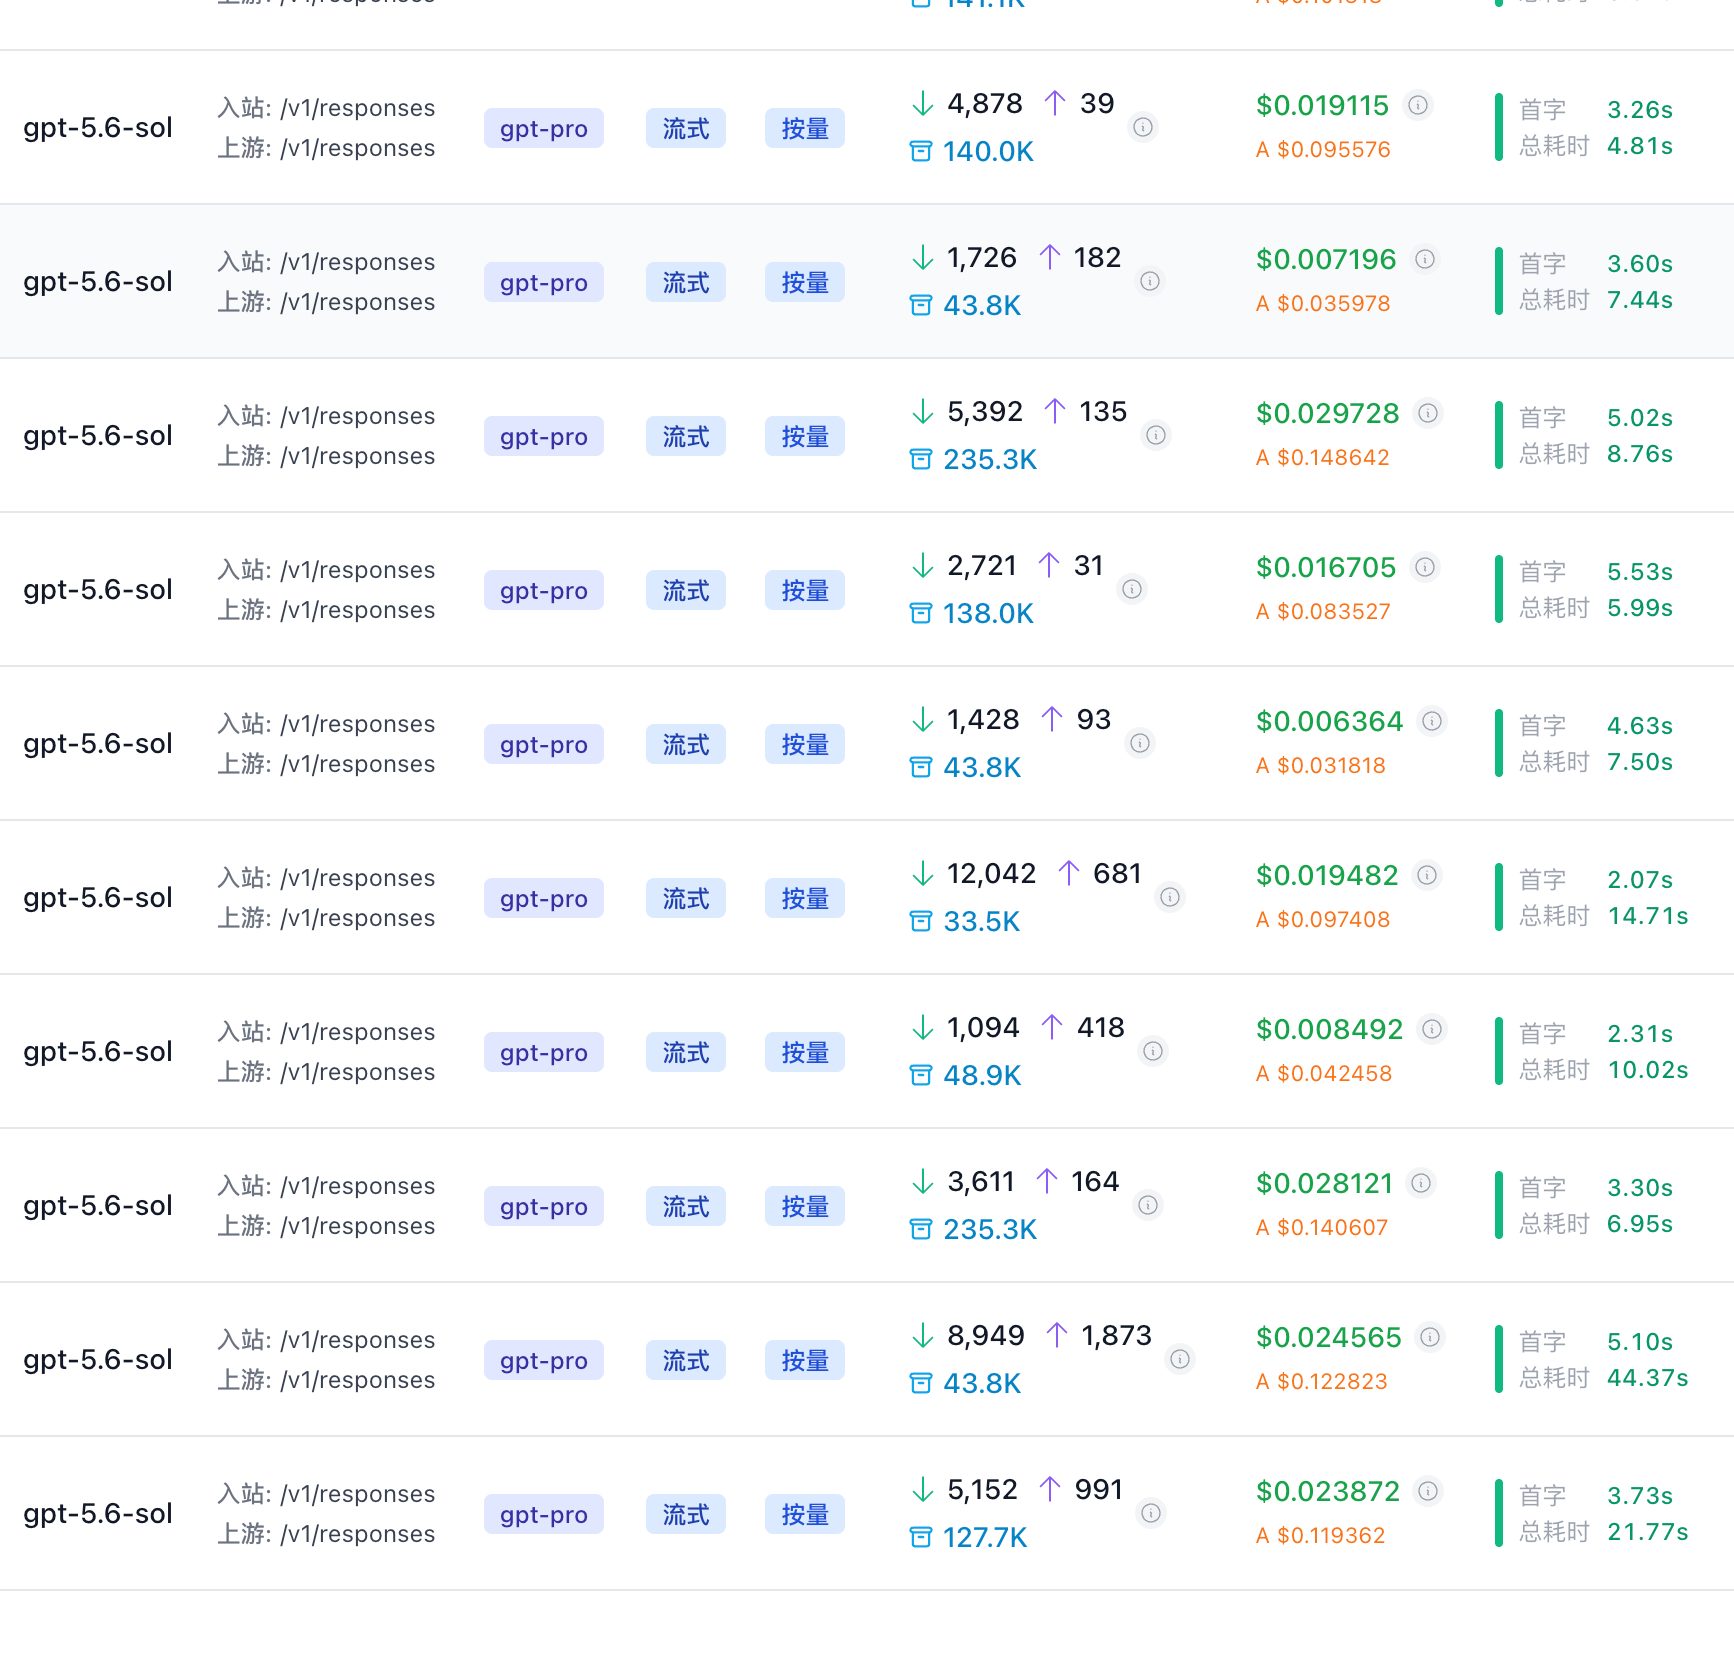
账号类型决定它现在是什么号,账号渠道决定这个号池到底稳不稳。嘴会说谎,使用记录不会。
这套判断方法我录了一期视频,配着真实后台记录逐条讲:B站视频版。xhyapi 自己就是按这套标准做的——自建、无上游、纯 Pro 号,欢迎拿这三个指标来查。
